
Note
Go to the end to download the full example code.
Nonlinear conjugate gradient vs. gradient descent#
Compares Polak-Ribiere nonlinear CG against plain gradient descent on the same ill-conditioned quadratic bowl – CG’s conjugate search directions avoid the zig-zagging that slows gradient descent down.
from mathematicskit.optimization import GradientDescent, NonlinearConjugateGradient, quadratic_bowl, quadratic_bowl_grad
from mathematicskit.optimization.utils.comparison import compare_optimizers
from mathematicskit.optimization.visualizers.plots import plot_convergence_comparison
Compare both methods from the same starting point#
optimizers = {
    "gradient_descent": GradientDescent(alpha=0.03, tol=1e-8, max_iter=2000),
    "conjugate_gradient": NonlinearConjugateGradient(tol=1e-8, max_iter=2000),
}
results = compare_optimizers(optimizers, quadratic_bowl, quadratic_bowl_grad, [5.0, -3.0])
for name, result in results.items():
    print(f"{name}: {result.iterations} iterations, x = {result.x}")
gradient_descent: 658 iterations, x = [ 9.88032321e-009 -3.56148881e-102]
conjugate_gradient: 38 iterations, x = [2.23413435e-09 5.77512021e-10]
Plot the convergence-rate comparison#
plot_convergence_comparison(results, quadratic_bowl, f_star=0.0)
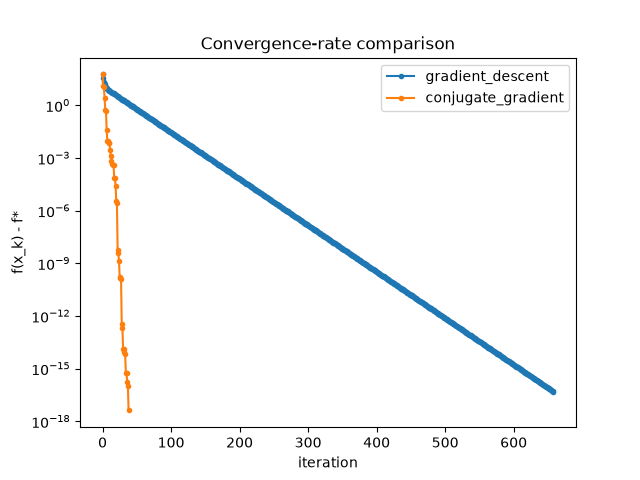
<Axes: title={'center': 'Convergence-rate comparison'}, xlabel='iteration', ylabel='f(x_k) - f*'>
Total running time of the script: (0 minutes 0.044 seconds)